PySpark初学者教程
PySpark初学者教程
Spark版本信息
本教程以下所有内容都是基于Spark3.5版本
1. PySpark简介
PySpark 教程 – PySpark 是一个用 Python 编写的 Apache Spark 库,用于使用 Apache Spark 功能运行 Python 应用程序。使用 PySpark 我们可以在分布式集群(多个节点)上并行运行应用程序。
换句话说,PySpark 是一个 Python API,是一个用于大规模强大的分布式数据处理和机器学习应用程序的分析处理引擎。
1.1 PySpark特点
- 内存计算
- 使用并行化进行分布式处理
- 可与许多集群管理器(Spark、Yarn、Mesos 等)一起使用
- 容错
- 不可变的
- 惰性评估
- 缓存和持久化
- 使用 DataFrame 时的内置优化
- 支持ANSI SQL
1.2 Pyspark优点
- PySpark 是一种通用的内存分布式处理引擎,可让您以分布式方式高效地处理数据。
- 在 PySpark 上运行的应用程序比传统系统快 100 倍。
- 使用 PySpark 进行数据摄取管道将给您带来巨大的好处。
- 使用 PySpark,我们可以处理来自 Hadoop HDFS、AWS S3 和许多文件系统的数据。
- PySpark 还用于使用 Streaming 和 Kafka 处理实时数据。
- 使用 PySpark 流式传输,您还可以从文件系统流式传输文件,也可以从套接字流式传输。
- PySpark 本身具有机器学习和图形库。
2. 什么是Apache Spark
Apache Spark是一个用于大规模数据处理的开源统一分析引擎,以下简称Spark。Spark 被设计为快速、灵活且易于使用,使其成为处理大规模数据集的流行选择。Spark 对分布式集群上数十亿和数万亿数据的运行速度比传统应用程序快 100 倍。
Spark可以运行在 单节点机器或多节点机器(集群)上。它的创建是为了 通过进行内存处理来解决MapReduce 的局限性。Spark 通过使用内存缓存来重用数据,以加速在同一数据集上重复调用函数的机器学习算法。这降低了延迟,使 Spark 比 MapReduce 快数倍,特别是在进行机器学习和交互式分析时。Apache Spark 还可以处理实时流。
它也是一个 多语言引擎, 为 Java、Scala、Python 和 R 等多种编程语言提供 API(应用程序编程接口)和库,允许开发人员使用他们最熟悉的语言来使用 Spark。
- Scala: Spark 的主要语言和母语是 Scala。Spark的许多核心组件都是用Scala编写的,它为Spark提供了最广泛的API。
- Java: Spark 提供了 Java API,允许开发人员在 Java 应用程序中使用 Spark。Java 开发人员可以通过此 API 访问 Spark 的大部分功能。
- Python: Spark 提供了一个名为 PySpark 的 Python API,它在喜欢使用 Python 进行数据分析和机器学习任务的数据科学家和开发人员中很受欢迎。PySpark 提供了一种与 Spark 交互的 Pythonic 方式。
- R: Spark 还提供 R API,使 R 用户能够使用 Spark 数据并使用他们熟悉的 R 语言执行分布式数据分析。
3. PySpark 架构
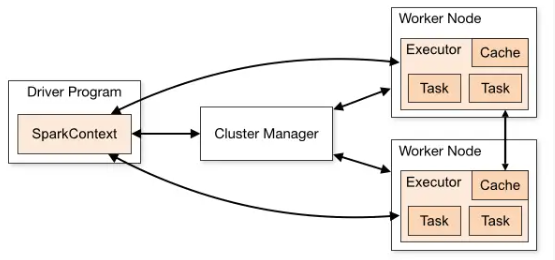
pyspark架构
Apache Spark 在主从架构中工作,其中主设备称为“Driver”,从设备称为“Workers”。当您运行 Spark 应用程序时,Spark Driver会创建一个上下文作为应用程序的入口点,所有操作(转换和操作)都在工作节点上执行,资源由 Cluster Manager 管理。